Friday, October 23, 2020

Path Analysis [1]

Materi ini dapat dilihat di:

https://www.youtube.com/watch?v=8R7aV7eKf-4

https://drive.google.com/file/d/1VoCnQtPCEw7fWalv_57m-kvKJG9WIuHk/view

Setelah file dta di load, berikut deskripsi datanya:

. desc
Contains data from D:\StataLat\regression data.dta
  obs:           140                          
 vars:            10                          23 Feb 2020 09:48
 size:         3,640                          
---------------------------------------------------------------------------------------------------------------------------
              storage   display    value
variable name   type    format     label      variable label
---------------------------------------------------------------------------------------------------------------------------
ïid             int     %8.0g                 id
perfgoal        float   %9.0g                 
achieve         float   %9.0g                 
mastery         float   %9.0g                 
interest        float   %9.0g                 
anxiety         float   %9.0g                 
genderid        byte    %8.0g                 
masterylmh      byte    %8.0g                 masteryLMH
perfgoallmh     byte    %8.0g                 perfgoalLMH
interestms      byte    %8.0g                 interestMS
---------------------------------------------------------------------------------------------------------------------------
Sorted by: 


Jalankan SEM Builder, dan buat diagramnya, binding variablenya, dan buat path nya. Setelah itu jalankan menu Estimation > Estimate. 


Perlu diperhatikan bahwa nilai diatas bukan nilai standardized. Jika ingin mengubah ke standardized, di menu Estimate > Estimation > Reporting, centang Report sebagai standardized.

Interpretasi:

mastery (penguasaan bahan) mempengaruhi secara positif interest (minat) dan minat mempengaruhi secara positif pencapaian (achieve).

tujuan performa (perfgoal) sedikit mempengaruhi axiety (kekuatiran, cemas), dan anxiety memberi pengaruh negatif terhadap pencapaian (achieve).

to be continued....

Covariance Matrix

Misalkan kita melakukan penelitian ke 3 orang, yaitu menyakan tingkat bahagia mereka jika makan apel dan pisang.

Didapatkan data sbb:


Orang ke tiga tidak suka buah, oleh karena itu tingkat kebahagiaan dia berkurang, baik jika makan apel ataupun pisang.

Jika digambarkan dalam bentuk vektor akan spt berikut.


Sekarang kita buat matrix nya. Karena variable nya 2, maka matrix nya 2x2.


Cov(a,b) = Cov(b,a)

Cov(a,b) = E(ab) - E(a)E(b)

Berarti kita perlu kolom axb, lalu mencari rata2nya.

Cov(a,b) = 0.666667 - 1.0 = 0.666667

Cov(a,a)

Cov(a,a) = E(a.a) - E(a)E(a) = 3.666667 - 1 = 2.666667

Cov(b,b)

Cov(b,b) = E(b.b) - E(b)E(b) = 0.666667 - 0 = 0.666667

Sehingga Covariance matrix menjadi:


Structural Equation Modeling - SEM

Kali ini kita mencoba explore terkait SEM dengan Stata.

Pembahasan akan dijadikan beberapa bagian.

Referensi tulisan ini: 

http://fmwww.bc.edu/EC-C/S2017/8823/ECON8823.S2016.nn15.slides.pdf

http://www.stata-press.com/data/r13/sem_sm2.dta

o Buku "Praktikum Analisis Statistik dengan Stata 12", Surya Darma, 2020


Structured Equation Modeling

SEM menggabungkan beberapa model pengukuran yang sebelumnya telah ada yaitu: (i) membahas hubungan antara variable yang bisa diukur (measured varible) dengan variable yang tidak bisa diukur (latent variable) menggunakan path analysis, dan menghubungkan variable-variable tsb dengan faktor penyebabnya (causal factor).

Contoh:

Pada kasus binomial probit model (model regresi dimana dependent variable nya hanya 1 atau 0), yaitu: Keputusan Membeli.

Keputusan Membeli ini disebabkan orang akan berpikir apa net benefit yang dia dapat. Sebagai contoh, membeli seharga Rp. 1 juta, mendapatkan jumlah barang terentu. Ada variable yang bisa diukur disini yaitu harga barang, jumlah barang, tingkat kepuasan pelayanan, dll. Sehingga keputusan (misalkan): "membeli".

Nah, variable "Keputusan Membeli" ini merupakan variable laten (tersembunyi), yang tidak diukur secara langsung, tapi bisa diukur dari faktor-faktor pembentuknya.

Contoh Kasus:

Contoh kasus berikut merupakan contoh SEM klasik, dari Buku "SEM with Stata", Acock, 2013, yaitu tentang analisa konsep Keterasingan (alienation) Individu.

Terdapat 3 variable latent: alineation tahun 1967 (alien67), alienation tahun 1971 (alien71), dan social economic status (status sosial) tahun 1966.


Diasumsikan variabelsocial status tahun 1966 mempengaruhi alienasi tahun 1967 dan juga mempengaruhi alienasi tahun 1971. Variable SES66 ini dipengaruhi level pendidikan (educ66) dan juga status pekerjaan (occstat66). Sedangkan variable keterasingan dipengaruhi anomia (semacam penyakit syaraf yang menyebabkan seseorang sulit mengeri makna perkataan lawan bicara), dan powerlessness (ketidakberdayaan).

Dalam model diatas ada 3 laten variable:

SES66 (exogenous)

Alien67 (endogenous)

Alien71 (endogenous)


Jika kita jalankan di SEM Builder Menu berikut: 

Estimation --> Estimate --> Model: Maximum Likehood | Reporting: Display Standardized Coeficient and Values 

maka akan didapat hasil sbb:

Terlihat bahwa: SES66 berpengaruh negatif ke Alien67 dan Alien71 sebesar -0.57, dan -0.15. Artinya semakin tinggi social economic status seseorang, semakin turun tingkat alineasinya. Demikian juga ada kontribusl Alien67 kepada Alien71 sebesar 0.66.

Sekarang kita periksa Goodness of Fit dari model tsb, untuk memeriksa seberapa variance dari masing-masing endogenous variable mampu dijelaskan oleh model.


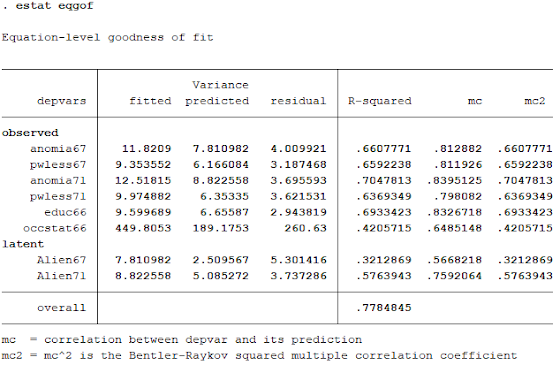
Kita lihat bahwa model mampu menjelaskan Alien67 sebesar 32.13% (R-Squrared). Dan model mampu menjelaskan Alien71 sebesar 57.74%.

Idealnya berdasarkan Buku Pak Surya (lihat halaman 114) dengan jumlah sampel hanya 15, maka loading factor dikatakan fit, jika nilainya > 0.75.

Terlihat loading factor yang tidak memenuhi kriteria tsb:

SES66 --> occstat66: 0.65

dan juga antara laten variable.


Goodnees of fit

p>chi2: 0.00 > 0.05 (false: artinya Ho ditolak, berarti model tidak begitu fit)

RMSEA: 0.108 <= 0.08 (false: artinya model tidak begitu fit)

CFI: 0.969 > 0.9 (true: artinya model fit)

SRMR: 0.021 < 0.08 (true: artinya model fit)


Terlihat bahwa model berdasarkan chi2 probability seharusnya H0 (model fit) ditolak, tapi dalam aturan SEM tidak otomatis di tolak.

Dapat disimpulkan bahwa model belum begitu fit.

Bagaimana cara mengimprove model?

Salah satu caranya adalah dengan membuat model lebih kompleks (dengan cara menambahkan degree of freedom). Kita tahu bahwa antara error dimodelkan tidak ada correlasi. Kita bisa coba mengkorelasikan error:

e.anomia67 --correlate-- e.anomia71

e.pwless67 --correlate-- e.pwless71


Indikasis ini bisa didapatkan juga dengan menjalankan 

.estat mindices


Terlihat jika korelasi antara e.anomia dan e.pwless dibentuk nilai EPC (Expected Parameter Change) nya cukup besar. Dengan menambahan 2 korelasi tersebut artinya degree of freedom kita tambahkan 2. Sehingga model menjadi lebih kompleks.

Setelah ditambahkan korelasi antara error variable tsb, gambarnya dan hasil mejalankan: di SEM Builder Menu berikut: 

Estimation --> Estimate --> Model: Maximum Likehood | Reporting: Display Standardized Coeficient and Values 

maka akan didapat hasilnya:

Terliha loading factor SES66 -- Alien71 meningkat dari -0.15 menjadi -0.21, dan efek dari Alien67 ke Alien72 telah berkurang dari 0.66 ke 0.57.

Covariance antara e.anomia juga positif, demikian juga dengan covariance e.pwless juga positif yang tidak 0.


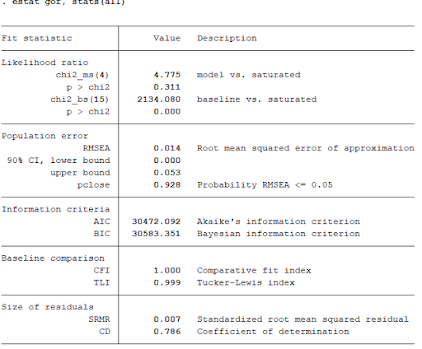
Likehood Ratio (LR) test antara model vs saturad Prob nya 0.3111 artinya > 0.05, sehingga H0 diterima, artinya sekrang model sudah fit.


Terlihat bahwa model mampu mejelaskan R-squared variable Alien67 dan Alien71 sebanyak 31.7% dan 49.7% (terjadi penurunan sedikit dari sebelumnya).

Goodnees of fit

p>chi2: 0.311 > 0.05 (true: artinya Ho diterima, berarti model fit)

RMSEA: 0.014 <= 0.08 (true: artinya model fit)

CFI: 1.000 > 0.9 (true: artinya model fit)

SRMR: 0.007 < 0.08 (true: artinya model fit)

Terlihat bahwa sekarang model sudah fit.


Wednesday, October 21, 2020

Anova One Way [1]

Analysis of Variance (ANOVA) adalah teknis statistik untuk meguji hipotesis, bahwa nilai rata-rata dari beberapa kelompok sample datang dari populasi yang sama atau tidak.

Sebelumnya tersedia t-test dimana ini hanya bisa membandingkan dua sample populasi dana mengujinya. Nah, Annova datang untuk menguji rata-rata sample dari lebih dari dua kelompok sample secara bersamaan. 

Misalkan ada 3 kelompok sample, masing-masing memiliki mean (rata-rata) dan jika ketiga kelompok itu digabung, akan terdapat mean total populasi.


Pada gambar diatas terlihat jika penjumlahan garis merah (Between) lebih besar dari penjumlahan garis biru (Within), artinya F hitung > F critical (table), maka H0 di reject.

            H0: mean u1 = u2 = u3

            Ha: setidaknya ada sepasang mean tidak sama

H0 direject artinya bahwa salah satu dari populasi itu (apakah u1, u2, atau u3) tidak masuk dalam kurva normal total populasi. Artinya, ke tiga group sample tsb salah satunya menjadi outlier, artinya H0 ditolak. 

HO direject jika:

If the calculated F-value > F-critical value, the null hypothesis (H0) is rejected

Karena P (prob) value ditentukan oleh nilai calcualated F-value ini, maka kriteria lain bisa digunakan:

If the p-value < the significance level (0.05), the null hypothesis (H0) is rejected and conclude that not all of population means are equal.

Case Study

Misalkan dilakukan pengukuran di sebuah bandara, atas 4 airline. Dilakukan survey meliputi: ticketing, boarding, Inflight service, baggage handling, pilot communication, dsb. Terdapat 25 pertanyaan, dan masing-masing pertanyaan berkisar 4 sangat bagus, 3 bagus, 2 cukup, 1 jelek. Dilakuan survey secara acak dengan mendapatkan 22 reponden. Semua jawaban responden dijumlahkan. Nilai maksimal yang mungkin pe responden adalah 100.

Berikut datanya.


H0: rata-rata kepuasan penumpang Nothern air, WTA air, Pocono air, dan Branson air adalah sama.

Mari kita hitung one-way anova. 

Btw, kenapa disebut one-way, karena kolom tsb hanya 1 kategori yaitu: Airline.


Dari data diatas didapat:

SST: 1485.090909            df = n -1 = 22-1 =21

SSC (Between): 890.6837662  df1= 21 - 18 = 3

SSE (Within): 594.4071429   df2 = n - (k - 1) = 21 - (4 - 1) = 18


Sehingga

MST: 1485.090909/21 = 70.71861472

MSC (Between): 890.6837662/3 = 296.8945887

MSE (Within): 594.4071429/18 = 33.02261905

        F = Between  
            Within 

                        296.8945887 / 33.02261905 
          8.990643302

F perhitungan 8.990643302

Jika dilihat di tabel:


terlihat Ftabel = 3.1599, sedangkan Fhitung = 8.990643302, artinya
 
F > Ftabel sehingga H0 ditolak.

Artinya, asumsi (H0): rata-rata tingkat kepuasan pelanggan 4 airline adalah sama, ditolak! Atau dengan kata lain, minimal ada satu airline yang rata-rata kepuasan pelangganya berbeda dengan airline lain.

Tapi airline manakah itu? Saat ini belum diketahui, perlu penelitian lebih lanjut.

BAGAIMANA MENENTUKAN F critical di Excel

Di Excel masukkan rumus = F.INV.RT(alpha, df numerator, df denumerator) , RT (Right Tail).

F critical = F.INV.RT(0.05, 3, 18) 
           = 3.15990759

PERHITUNGAN ANOVA DENGAN STATA

Jika dihitung dengan Stata, hasilnya sama dengan hitung manual diatas.

. tabstat Productivity, statistics (n sum mean v) by (Airline)

Summary for variables: Productivity
     by categories of: Airline 

Airline |         N       sum      mean  variance
--------+----------------------------------------
Branson |         6       414        69      13.6
Nothern |         4       349     87.25  36.91667
 Pocono |         7       510  72.85714  30.14286
    WTA |         5       391      78.2      58.7
--------+----------------------------------------
  Total |        22      1664  75.63636  70.71861
-------------------------------------------------

. oneway Productivity Airline

                        Analysis of Variance
    Source              SS         df      MS            F     Prob > F
------------------------------------------------------------------------
Between groups      890.683766      3   296.894589      8.99     0.0007
 Within groups      594.407143     18    33.022619
------------------------------------------------------------------------
    Total           1485.09091     21   70.7186147

Bartlett's test for equal variances:  chi2(3) =   2.1355  Prob>chi2 = 0.545

Terlihat dalam hitungan Stata F = 8.99 > F tabel 3.1599, dan Prob 0.0007 < 0.05, yang berarti H0 ditolak. Artinya rata-rata kepuasan pelanggan pada 4 airline itu berbeda.

EXCEL Analysis Toopack

Jika kita mengaktifkan Analysis Toolpack di Excel, maka kita juga bisa mendapatkan hasil yang sama, sbb.


Terlihat p-value 0.00743 < 0.05 (H0 ditolak).


Regresi Linear - Hitung Manual [4] - Covariance & Corelation

Perhitungan Covariance dan Correlation

Covariance menjelaskan apakah ada hubungan (korelasi) positf antara 2 variable, atau hubungan negatif, atau tidak ada hubungan (covariance = 0).

Covariance tidak bisa menentukan seberapa "magnitude" dari korelasi tsb. Diperlukan koefisien korelasi yang bisa dihitung dari Covariance, untuk meggambarkan seberapa magnitude dari korelasi tsb.

Rumusnya sbb:

Covariance (x, y) = Sigma { ( x - x rata ) (y - y rata) / (n -1) } 

Correlation (x,y) = Covariance (x,y) / ( stdev(x) . stdev (y) )

Jika dihitung pakai excel sbb:

y x a b (a x b)/( n-1)

BILL TIP  

34 5 -40 -5 40

108 17 34 7 47.6

64 11 -10 1 -2

88 8 14 -2 -5.6

99 14 25 4 20

51 5 -23 -5 23

rata2 74 10 123     

stdev 29.00344807 4.898979486 0.865665    

n = 6


Kolom a --> 34 - 74 = -40 | 108 - 74 = 34, dst

Kolom b --> 5 - 10 = -5 | 17 - 10 = 7, dst

Kolom setelahnya --> -40 x - 5 / (6-1) = 40 | 34 x 7 / (6-1) = 47.6, dst

Covariance = 40 + 47.6 - 2 - 5.6 + 20 + 23 = 123

Correlation = 123 / (29.00344807 x 4.898979486) = 0.865665 


Jika menggunakan STATA:

Covariance

. correlate tip bill, covariance

(obs=6)


             |      tip     bill

-------------+------------------

         tip |       24

        bill |      123    841.2


Correlation Coeficient

. correlate tip bill

(obs=6)


             |      tip     bill

-------------+------------------

         tip |   1.0000

        bill |   0.8657   1.0000


Interpretasi:

Antara TIP dan BILL terdapat korelasi positif (terliat dari covariance yang positif 123). Terdapat koefisien korelasi sebesar 0.8657. Artinya TIP dan BILL saling berkorelasi sebesar 86.57%.

Perlu diingat bahwa Correlation tidak bisa menentukan arah, variable mana menentukan variabel mana. Yang pasti kedua variable tsb saling berkorelasi. 

Apakah koefisien korelasi ini significant?

Fungsi Correlation tidak bisa mengukur ini. Akan tetapi Pearson Correlation bisa.

. pwcorr tip bill, sig star(.05) obs


             |      tip     bill

-------------+------------------

         tip |   1.0000 

             |

             |        6

             |

        bill |   0.8657*  1.0000 

             |   0.0259

             |        6        6


Terlihat bahwa koefisien korelasi 0.8657 adalah significant (0.0259 < alpha 0.05)

Regresi Linear - Hitung Manual [3] - Standardized Regression z

Kali ini kita akan bahas perbedaan Linear Regression dan Standardized Regression.

Dalam situasi nyata, terkadang independent variable datang dalam unit yang berbeda (misal variable semprotan minyak wangi dalam unit mililiter, dengan jumlah air yang diminum dalam satuan liter).

Terkadang kita perlu menormalkan / menstandardkan nya.

Teknik menstandarkan data, adalah dengan mentransformasikan ke domain z, yaitu variance dibagi standar deviasi. Karena unit penyebut dan pembilang sama, maka z ini sudah tidak ada dimensinya (meter, liter, Rp, watt, celcius, dsb).


Secara manual dapat dihitung sbb:


Di gambar diatas diberikan contoh perhitungan manual standardized value zBill (kotak kuning) dan zTip (kotak hijau):

( 34 - 74 ) / 29.00345 = -1.37915  
(14 - 10 ) / 4.898979 = 0.816497


Rumus daripada Variable BILL dan TIP, di transformasikan menjadi variable zBill dan ZTip sbb:

zBill = xi - mean(xi) / stdev (x)

zTip = yi - mean(yi) / stdev (y)


Setelah mendapatkan data point yang baru, kita scatterplot di excel dan dengan memilih show formula. Excel memunculkan formula garis regresi:

y = 0.8657x + 5e-17


Jika zBill dan zTip di regresi kan dengan Stata didapat hasil sbb:


untuk Coefisien slope hasil yang didapat sama dengan Excel 0.8657 (dan ini sekaligus menjadi Pearson Correlation Coefisien). Akan tetapi intercept yang didapat Stata berbeda dengan Excel (walaupun bisa dibilang sama karena -0.00000000478 (Stata) bisa dibilang sama dengan Excel -0.00000000000000005), alias dibulatkan menjadi 0. Dan memang ini benar. Karena standardized regression ini akan melewati titik (0,0).

Jadi bisa dikatakan bahwa linier regression ke standadized regresion, adalah upaya untuk mentransformasikan nilai-nilai ke domain yang baru yang lebih standardized (dimana rentang nilainya lebih dekat satu sama lain).


Ini seperti mentransformasikan daya pemancar radio dalam miliWatt, ke desibel miliWatt (dBm), atau transformasi fourier, dsb. 

Bagaimana menggenerate Standardive Value di Stata?

Caranya mudah, generate variable baru dengan perintah egen.

. egen zBill = std (bill)

. egen zTip = std (tip)

. list

     +------------------------------------+

     | bill   tip       zBill        zTip |

     |------------------------------------|

  1. |   34     5   -1.379146   -1.020621 |

  2. |  108    17    1.172274    1.428869 |

  3. |   64    11   -.3447866    .2041242 |

  4. |   88     8    .4827012   -.4082483 |

  5. |   99    14    .8619665    .8164966 |

  6. |   51     5   -.7930092   -1.020621 |

     +------------------------------------+


Tampak value dari standardized di zBill dan zTip, sesuai dengan perhitungan manual.

APA YANG TETAP?

Menarik diperhatikan walau data-data di transformasi jadi Standardized (artinya data-data bebas dari measurement unit, spt kg, meter, celcius, dsb), namum antara non-Standardized dengan Standardized, hasil regresi sama, yaitu pada bagian:

F test khususnya untuk:

- R squared akan sama

- Perbandingan SSModel dengan SSResidual akan sama

t test khususnya untuk:

- t value

- P value

Perhatikan gambar berikut. 


Dapat dilihat bahwa, hasil F test dan t test sama.

Rasio SS Model dan SS Residual juga sama:

89.925107 / 30.074893 = 2.990039 (non-standardized regression)

3.74687946 / 1.25312046 = 2.990039 (standardied regression)

Yang berbeda adalah slope dan intercept, dan ini memang normal, karena data-data semua sudah ditransmormasikan menjadi data-data normalized.


Tuesday, October 20, 2020

Regresi Linear - Hitung Manual [2] - SS Residual Root MSE

Ini adalah artikel lanjutan dari sebelumnya. Jika Anda belum membacanya harap membaca artikel tsb terlebih dahulu.

MEAN SQUARE ERROR (MS Error)

Rumusnya adalah 

   MSE = SSE / N (N jumlah populasi)

   MSE = SSE / df (df degree of freedom)

   df = n - 2 (n jumlah sample observasi, 2 adalah 2 variable)

Karena kita menggunakan sample (sebanyak 6), bukan populasi, maka:

MSE = 30.07489301 / (6 - 2) = 7.518723252

Nilai ini sesuai dengan hasil STATA kotak warna merah.


ROOT MEAN SQUARE ERROR (s)

Root mean square error, atau kadang disebut standar error dari estimasi (ini mirip-mirip standar deviasi) adalah akar (root) dari MS Error.

Root MSE = sqrt (MSE residual)

Root MSE = sqrt ( 7.518723252 ) = 2.742029039

Root MSE dihitung manual didapat 2.742029039, sesuai dengan hasil STATA kotak warna merah.


Interpretasi:

Jarak rata-rata antara data-point TIP dengan garis regresi adalah senilai $2.742. Artinya jika anda sebagai manager restoran, ingin menetapkan berapa TIP yang pas untuk sebuah menu baru, seharga $20, maka ingat rumus garis regresinya:

y = 0.146 x 20 - 0.82 = $2.1 

Jika RMSE diterapkan +/-  $2.742, maka kisaran TIP maksimal yang masih wajar:

$4.842 sekitar $5.

Jika anak buah Anda kasih TIP $10 misalkan, maka ini bisa dibilang lebay.... :)

Nilai RMSE (atau standar error of the estimate) ini bisa memberikan gambaran seberapa bagus model dapat digunakan untuk bisa membuat prediksi. Apabila RMSE terlalu besar tentu berarti modelnya tidak baik untuk melakukan prediksi.

Selain itu RMSE dapat digunakan juga untuk membuat interval prediksi (dibahas lebih lanjut).

Kesimpulan untuk SSR MSR dan RMSE digambarkan sbb:


Perlu diingat bahwa:

SS Residual, MS Residual berada dalam nilai kuadrat. Sehingga nilainya jangan dibayangkan sebagai US$. Dimana SS Residual adalah nilai total seluruh observasi, sedangkan MS Residual apabila "dilihat" per observasi.

Akan tetapi Root MSE, atau estimasi standar error, ini sudah di lakukan operasi square (akar), sehingga bisa dibanyangkan dalam unit yang sama (yaitu US$).

R-squared (r^2)

Rumus dari R-squared adalah sbb: 

R-squared = SSModel / SSTotal

          89.92510699   /  120

          = 0.749375892 ~ 75%

Apa interpretasi R-squared ini?

Ini berarti model tsb berhasil menjelaskan bahwa variable BILL mempengaruhi variable TIP sebanyak 75%. Sedangkan 25% lagi variable BILL dipengaruhi oleh variable lain yang belum diketahui.  

Ingat kembali perbedaan model dalam ilmu eksak dan sosial adalah bahwa dalam ilmu eksak variable dependent sudah pasti ditentukan oleh variable independent.

Semisal: F = m . a (gaya = massa dikali percepatan)

Tidak ada variable lain yang mempengaruhi F. Ini berarti r^2 akan 100%. Artinya variable mass dan gaya 100% mempengaruhi variabel F.

Dalam ilmu sosial tidak begitu.

Misalkan kita bilang: semangat kerja = gaji x slope + intercept. Apakah semangat kerja dipengaruhi 100% oleh gaji? Tentu tidak. Bisa jadi jarak dari rumah, kemaceten dijalan, dll mempengaruhi semangat kerja.

Artinya nilai r^2 (R squred) nya tidak akan 100%. Misal dalam perhitungan STATA ditemukan r^2 60%, ini berarti, variable gaji mempengaruhi semangat kerja sebanyak 60%, sedangkan 40% nya dipengaruhi faktor lain (variable lain) yang belum diteliti.
 

So far, kesimpulan Regresi Linear

Kita sudah liat dan dapat penjelasan tentang hal-hal yang penting dalam membaca output regresi liner di STATA. Antara lain:

1. SS Model mendekati SS Total 

SS Model haruslah sebesar mungkin mendekati SS Total, dan SS Residual haruslah sekecil mungkin. Jika kondisi ini tidak tercapai maka model garis regresi kita tidak bagus.

2. R-squared yang besar 

R-squared sebaiknya besar. Jika R-squred hanya kecil misal 20%, maka ini menyatakan bahwa variable independent mempengaruhi variable dependent sebanyak 20%. Artinya ada 80% variable lain yang tidak diketahui saat ini. 

3. P > |t| nilainya kurang dari 5% (0.05)

Jika nilai ini > 0.05 maka hipotesis ditolak. Artinya model regresi liner tidak bagus, dan tidak bisa diterima.

4. 95% Conf. Interval tidak mengandung nilai 0

Artinya intervalnya harus >=0  

5. Dapat juga ditambahkan Pearson correlation significant > 0.05, dan Kekuatan korelasinya diatas 0.3 atau diatas .5.

Coefficient ValueStrength of Association
0.1 < | r | < .3small correlation
0.3 < | r | < .5medium/moderate correlation
r | > .5large/strong correlation

  pwcorr Var1 Var2, sig star(.05) obs


EFEK DARI OUTLIER

Sebagai penutup, kita akan liat efek dari outlier.

Data awal adalah sbb:

. list bill tip


     +------------+

     | bill   tip |

     |------------|

  1. |   34     5 |

  2. |  108    17 |

  3. |   64    11 |

  4. |   88     8 |

  5. |   99    14 |

     |------------|

  6. |   51     5 |

     +------------+


Bagaimana kalau kita simulasikan baris ke 2, jika harga Bill 108, maka tip nya $1 (alih-alih $17). Apa yang akan terjadi?


Data kita ubah:

. replace tip = 1 in 2

(1 real change made)


. list bill tip


     +------------+

     | bill   tip |

     |------------|

  1. |   34     5 |

  2. |  108     1 |

  3. |   64    11 |

  4. |   88     8 |

  5. |   99    14 |

     |------------|

  6. |   51     5 |

     +------------+

Dan ini perbandingan hasil regresinya.


Interpretasi:

1. R-squared turun drastis ketika ada oulier, menjadi 1.1% (dari sebelumnya 74.9%). Artinya variable BILL hanya berkontribusi 1.1% terhadap variable TIP, atau dengan kata lain bisa dikatakan TIP dipengaruhi 98.9% oleh variable yang belum diketahui. Tentu ini tidak baik, karena terlalu banyak variable unkwon yang mempengaruhi TIP.

2. SS Model (Sum of Square Error for Model) 1.2, sedangkan SST 109, Residu 108. Padahal model regresi seharusnya menurunkan SS Residu sekecil mungkin menjadi 0. Dengan adanya outlier, maka Error Residu sangat besar.

3. P>|t| menjadi > 0,05, artinya model ini tidak significant

4. Demikian juga intervar dari slope antara nilai minus ke plus, artinya ada nilai 0 diantaranya (slope 0), ini artinya model ditolak


TENTANG BLOG INI

Blog ini merupakan tempat bagi penulis untuk menorehkan catatan-catatan selama penulis mempelajari ilmu statistik menggunakan software STATA...